Choisissez la configuration qui correspond à votre patience, votre confidentialité et votre budget.
WebBrain intègre 114 cartes de fournisseurs couvrant les services cloud hébergés, les API cloud directes, les routeurs de modèles et les serveurs locaux compatibles OpenAI. Un seul fournisseur actif est nécessaire.
Choix rapide
WebBrain Compass
Intégré, actif par défaut et doté d'un quota quotidien gratuit, sans serveur de modèles ni clé API.
Modèle local
Utilisez llama.cpp, Ollama, ODS, LM Studio, Jan, vLLM, SGLang ou LocalAI.
API cloud
Fournissez votre propre clé pour OpenAI, Anthropic, Gemini, Mistral, DeepSeek, xAI, Groq et autres fournisseurs pris en charge.
Routeur de modèles
Passez d'un modèle à l'autre avec un seul compte ; idéal pour les utilisateurs qui expérimentent souvent.
114 cartes de fournisseurs intégrées
La page Fournisseurs ajoute 79 API directes et routeurs, dont Azure AI Foundry, Vertex AI, Vertex Anthropic, Cerebras, Cohere, DeepInfra, Perplexity, Vercel AI Gateway, Venice et de nombreux forfaits de codage régionaux. Recherchez par fournisseur ou par nom de modèle.
La plupart des cartes utilisent une clé API et un point de terminaison compatible OpenAI. Les cartes Vertex utilisent un projet Google Cloud, un emplacement et une clé d'autorisation ; l'emplacement global utilise le point de terminaison global de Google, et Vertex Anthropic prend aussi en charge les hôtes multi-régions us et eu. Cloudflare accepte un ID AI Gateway facultatif ; pour les modèles @cf/, la passerelle default est utilisée automatiquement quand le champ est vide. Les fournisseurs prenant en charge le streaming affichent les réponses en temps réel dans Ask interactif et réessaient une fois sans streaming si la connexion se termine trop tôt. Lorsque le service renvoie la consommation de jetons, elle est enregistrée directement ; sinon WebBrain enregistre une estimation prudente afin que le streaming ne contourne pas les limites de coût.
GitHub ne va pas disparaître, mais GitHub Models sera retiré le 30 juillet 2026. GitHub Copilot exige un abonnement ou une intégration OAuth distincte. GitLab Duo et SAP AI Core exigent également une authentification et une découverte de déploiement dédiées que l'extension de navigateur ne prend pas en charge.
Étapes de configuration
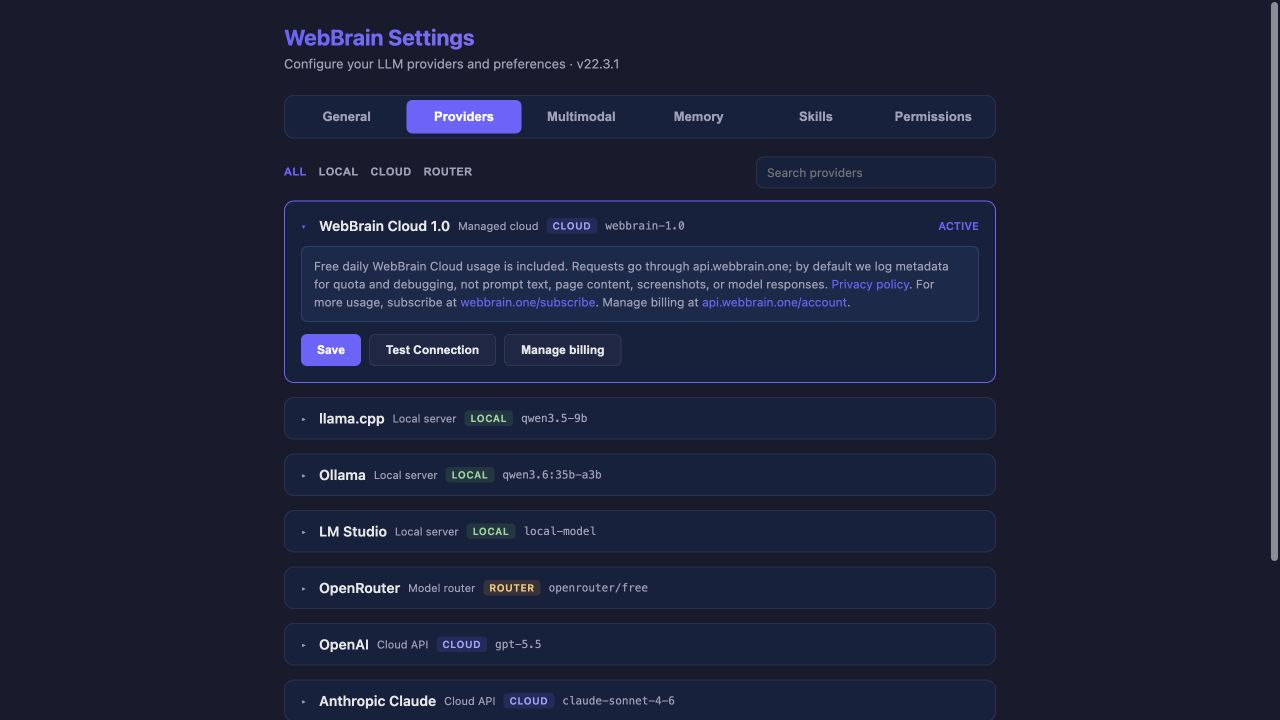
- Ouvrez la page Fournisseurs. Choisissez Plus… dans le menu des modèles de la barre latérale, ou le lien « Fournisseurs » en haut de la page des paramètres. L'onglet LLM répertorie les fournisseurs de chat.
- Trouvez le fournisseur. Utilisez « Local », « Cloud », « Routeur » ou le champ de recherche.
- Dépliez la carte et saisissez les valeurs. Les serveurs locaux exigent généralement une adresse et un nom de modèle ; les fournisseurs cloud exigent aussi une clé API.
- Enregistrez. Écrit les champs actuels dans le navigateur.
- Testez la connexion. Corrigez d'abord les erreurs d'adresse, de clé, de modèle ou de serveur.
- Rendez actif. Uniquement après la réussite du test. Enregistrer ne vaut pas activer.
Signification des champs
| Champ | Signification | Conseil |
|---|---|---|
| Serveur / Base URL | Point de terminaison racine compatible OpenAI ou racine de l'API du fournisseur. | Utilisez la valeur exacte indiquée par votre application locale ou votre fournisseur ; ne collez pas l'URL d'une page de chat. |
| Clé API | Identifiant envoyé au fournisseur pour l'authentification. | Normalement inutile pour les serveurs locaux, sauf si vous avez activé l'authentification. |
| Modèle | Identifiant de modèle attendu par le serveur. | La casse, les préfixes et l'orthographe doivent être exacts. |
| Fenêtre de contexte | Quantité de prompt, d'historique, de contenu de page et de schémas d'outils tenant dans une requête. | Visez au moins 16k pour des exécutions locales fiables ; 8k peut fonctionner avec Compact ; 4k est trop petit. |
| Prend en charge la vision | Le modèle actuel accepte-t-il les images ? | Activez uniquement si vous êtes sûr que le modèle servi prend en charge les images. |
| Palier de prompt | Longueur du prompt et portée des outils navigateur habituels exposés par WebBrain. | Commencez à Mid pour les modèles locaux ; Compact pour les petits contextes, Full pour les modèles performants. |
Modèles locaux : les étapes supplémentaires
| Serveur | Base URL habituelle | Clé API |
|---|---|---|
| llama.cpp | http://localhost:8080 | En général aucune |
| Ollama | http://localhost:11434/v1 | Aucune |
| ODS | http://localhost:11434/v1 | Facultative ; utilisez le port du fichier .env d'ODS |
| LM Studio | http://localhost:1234/v1 | Aucune |
| Jan | http://localhost:1337/v1 | Facultative |
| vLLM | http://localhost:8000/v1 | Facultative |
| SGLang | http://localhost:30000/v1 | Facultative |
Une connexion refusée signifie souvent que le serveur n'est pas démarré ou que le port est erroné ; les erreurs CORS/Origin exigent d'autoriser l'origine des extensions de navigateur. Pour Ollama : OLLAMA_ORIGINS="chrome-extension://*,moz-extension://*" ollama serve.
Paliers de prompt
Les fournisseurs cloud utilisent Full en permanence ; les fournisseurs locaux utilisent Mid par défaut ; les fournisseurs Compact ne peuvent pas utiliser le mode Dev.
Quand le test de connexion échoue
- Connection refused :Démarrez le serveur local et vérifiez le port.
- CORS/Origin :Autorisez l'origine de l'extension WebBrain dans le serveur.
- Unauthorized :Vérifiez que la clé et la Base URL appartiennent au même fournisseur.
- Model not found :Copiez l'ID de modèle exact ou utilisez Load models.
- Délai dépassé :Augmentez le délai des requêtes LLM dans « Paramètres → Budgets » pour les gros modèles locaux sur CPU.
- Échec après quelques tours :Vérifiez la vraie fenêtre de contexte ; abaissez le palier de prompt ou élargissez le contexte du modèle.
Modèles d'assistance facultatifs
Le fournisseur actif gère la conversation principale, la planification et les réponses finales. Les autres onglets de la page Fournisseurs configurent indépendamment un modèle vision, un point de terminaison voix (parole vers texte), les médias génératifs, les modèles de décision et SafeSocial. Ces réglages ne dépendent pas du filtrage ni du changement de fournisseur.
Les modèles de vision et de décision sont par défaut sur Auto : dans Chrome, Compass VLD v6 2B est utilisé une fois son téléchargement terminé (à défaut Compass VLD Tiny v5 si c'est le seul téléchargé ; si aucun des deux n'est présent et que seuls Ternary Bonsai 2 2B Vision ou D1 sont téléchargés, le premier lit les captures d'écran et le second répond aux décisions ; lorsque WebBrain Cloud est actif, le modèle de décision géré de Compass traite les décisions), et rien avant le téléchargement. Un modèle de décision ne répond qu'aux questions fermées (oui/non ou choix multiples) comme « Cette tâche est-elle terminée ? » ; choisissez Activé pour que OpenRouter, TypeSafe, un serveur local, D1 ou le modèle intégré au navigateur répondent à toutes les décisions, ou Désactivé pour ne jamais en utiliser. Les autorisations et les contrôles d'achèvement existants s'appliquent toujours. Consultez Modèles de vision, de voix et de décision pour la configuration et le partage des données.