Elige la configuración que se adapte a tu paciencia, tu privacidad y tu presupuesto.
WebBrain incluye 114 tarjetas de proveedores que abarcan servicios cloud gestionados, API cloud directas, enrutadores de modelos y servidores locales compatibles con OpenAI. Solo necesitas un proveedor activo.
Elección rápida
WebBrain Compass
Integrado y activo por defecto, con una asignación diaria gratuita; sin servidor de modelos ni clave API.
Modelo local
Usa llama.cpp, Ollama, ODS, LM Studio, Jan, vLLM, SGLang o LocalAI.
API en la nube
Introduce tu propia clave para OpenAI, Anthropic, Gemini, Mistral, DeepSeek, xAI, Groq y otros proveedores admitidos.
Enrutador de modelos
Cambia entre muchos modelos con una sola cuenta; ideal para quienes experimentan a menudo.
114 tarjetas de proveedores integradas
La página de proveedores añade 79 API directas y enrutadores, incluidos Azure AI Foundry, Vertex AI, Vertex Anthropic, Cerebras, Cohere, DeepInfra, Perplexity, Vercel AI Gateway, Venice y muchos planes regionales de programación. Puedes buscar por proveedor o por nombre de modelo.
La mayoría de las tarjetas usan una clave API y un endpoint compatible con OpenAI. Las tarjetas Vertex usan un proyecto de Google Cloud, una ubicación y una clave de autorización; la ubicación global usa el endpoint global de Google, mientras que Vertex Anthropic admite además los hosts multi-región us y eu. Cloudflare acepta un ID de AI Gateway opcional; para los modelos @cf/, se usa automáticamente la puerta de enlace default si el campo queda vacío. Los proveedores con streaming muestran las respuestas en tiempo real en Ask interactivo y reintentan una vez sin streaming si la conexión termina antes de tiempo. Cuando el servicio informa el uso de tokens, se registra directamente; en caso contrario WebBrain registra una estimación conservadora para que el streaming no eluda los límites de coste.
GitHub no va a desaparecer, pero GitHub Models se retira el 30 de julio de 2026. GitHub Copilot requiere una suscripción o integración OAuth aparte. GitLab Duo y SAP AI Core también requieren autenticación y descubrimiento de despliegue específicos que la extensión del navegador no admite.
Pasos de configuración
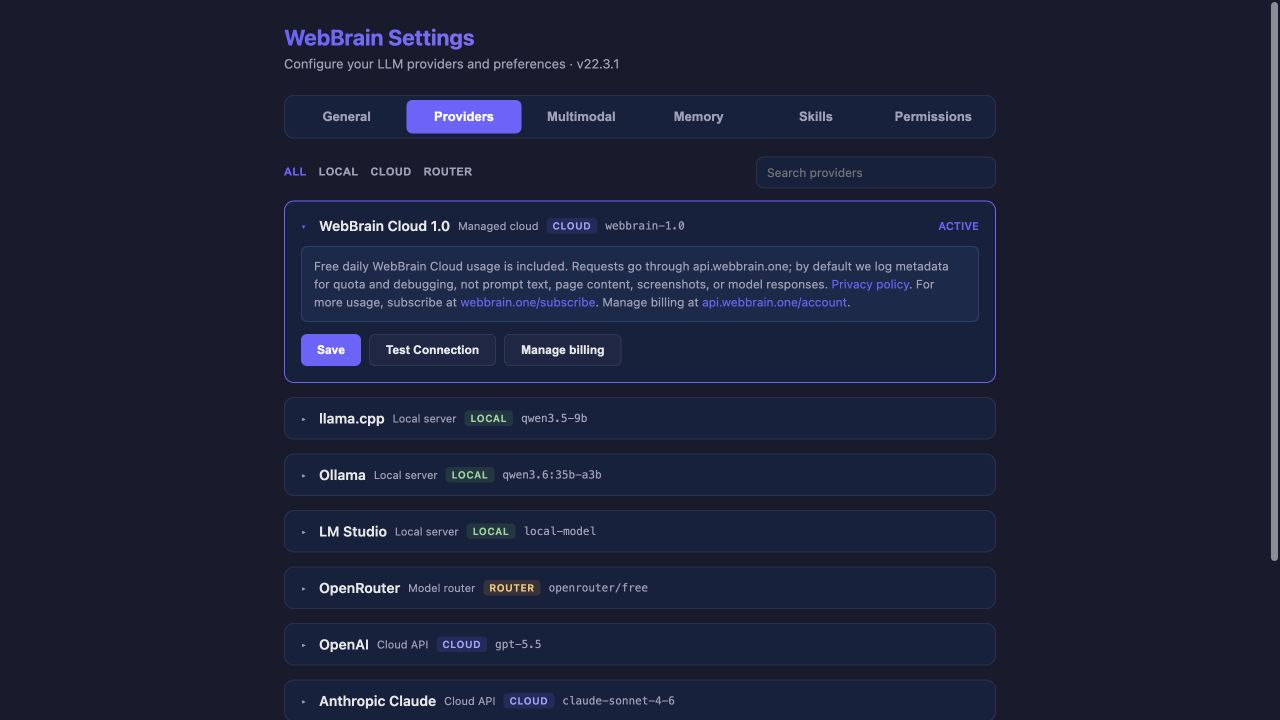
- Abre la página de proveedores. Elige Más… en el menú de modelos de la barra lateral, o el enlace «Proveedores» en la parte superior de la página de ajustes. La pestaña LLM enumera los proveedores de chat.
- Encuentra el proveedor. Usa «Local», «Nube», «Enrutador» o el cuadro de búsqueda.
- Despliega la tarjeta y rellena los valores. Los servidores locales suelen necesitar una dirección y un nombre de modelo; los proveedores en la nube también una clave API.
- Guarda. Escribe los campos actuales en el navegador.
- Prueba la conexión. Corrige primero los errores de dirección, clave, modelo o servidor.
- Actívalo. Solo después de que la prueba tenga éxito. Guardar no significa activar.
Qué significan los campos
| Campo | Significado | Consejo |
|---|---|---|
| Servidor / Base URL | Punto de terminación raíz compatible con OpenAI o raíz de la API del proveedor. | Usa el valor exacto que muestra tu aplicación local o el proveedor; no pegues la URL de una página de chat. |
| Clave API | Credencial enviada al proveedor para autenticarse. | Los servidores locales normalmente no la necesitan, salvo que hayas activado la autenticación. |
| Modelo | Identificador de modelo que exige el servidor. | Deben coincidir exactamente mayúsculas, prefijos y ortografía. |
| Ventana de contexto | Cantidad de prompt, historial, contenido de página y esquemas de herramientas que caben en una petición. | Al menos 16k para funcionar con fiabilidad en local; 8k puede funcionar con Compact; 4k es demasiado pequeño. |
| Admite visión | Si el modelo actual acepta imágenes. | Actívalo solo cuando sepas con certeza que el modelo servido admite imágenes. |
| Nivel de prompt | Longitud del prompt y alcance de las herramientas de navegador habituales que expone WebBrain. | Empieza con Mid en modelos locales; Compact para contextos pequeños y Full para modelos capaces. |
Modelos locales: pasos adicionales
| Servidor | Base URL habitual | Clave API |
|---|---|---|
| llama.cpp | http://localhost:8080 | Normalmente ninguna |
| Ollama | http://localhost:11434/v1 | Ninguna |
| ODS | http://localhost:11434/v1 | Opcional; usa el puerto del .env de ODS |
| LM Studio | http://localhost:1234/v1 | Ninguna |
| Jan | http://localhost:1337/v1 | Opcional |
| vLLM | http://localhost:8000/v1 | Opcional |
| SGLang | http://localhost:30000/v1 | Opcional |
Una conexión rechazida suele significar que el servidor no está iniciado o que el puerto es incorrecto; los errores CORS/Origin requieren permitir el origen de las extensiones del navegador. En Ollama: OLLAMA_ORIGINS="chrome-extension://*,moz-extension://*" ollama serve.
Niveles de prompt
Los proveedores en la nube usan Full siempre; los locales usan Mid por defecto; los proveedores Compact no pueden usar el modo Dev.
Cuando falla la prueba de conexión
- Connection refused:Inicia el servidor local y confirma el puerto.
- CORS/Origin:Permite el origen de la extensión WebBrain en el servidor.
- Unauthorized:Comprueba que la clave y la Base URL pertenecen al mismo proveedor.
- Model not found:Copia el ID de modelo exacto o usa Load models.
- Tiempo de espera agotado:Aumenta el tiempo de espera de peticiones LLM en «Ajustes → Presupuestos» para modelos locales grandes en CPU.
- Fallo tras unos turnos:Confirma la ventana de contexto real; baja el nivel de prompt o amplía el contexto del modelo.
Modelos de asistencia opcionales
El proveedor activo gestiona la conversación principal, la planificación y las respuestas finales. Las demás pestañas de la página de proveedores configuran de forma independiente un modelo de visión, un endpoint de voz (voz a texto), medios generativos, modelos de decisión y SafeSocial. Estos ajustes son independientes del filtrado y del cambio de proveedor.
Los modelos de visión y decisión están por defecto en Auto: en Chrome se usa Compass VLD v6 2B una vez descargado (o Compass VLD Tiny v5 si es el único descargado; si no hay ninguno de los dos y están descargados Ternary Bonsai 2 2B Vision o D1, el primero lee capturas y el segundo responde decisiones; con WebBrain Cloud activo, el modelo de decisión gestionado de Compass trata las decisiones), y nada antes de la descarga. Un modelo de decisión solo responde preguntas de sí/no o de opción múltiple como «¿Está terminada esta tarea?»; elige Activado para que OpenRouter, TypeSafe, un servidor local, D1 o el modelo del navegador respondan todas las decisiones, o Desactivado para no usar nunca uno. Los permisos y las comprobaciones de finalización existentes siguen aplicándose. Consulta Modelos de visión, voz y decisión para la configuración y el uso compartido de datos.